Porté par Balaji Prabhakar, professeur et co-inventeur de DCQCN, le contrôle de congestion des réseaux RDMA, et par son ancien étudiant Yilong Geng, Clockwork est né d’un projet de systèmes distribués à l’Université de Stanford. Mendel Rosenblum, fondateur de VMware et créateur de l’hyperviseur ESXi, s’est également impliqué dès les débuts du projet. De 2017 à 2021, l’équipe synchronise les horloges de dizaines de milliers de machines, y compris entre continents. La précision atteint quelques dizaines de nanosecondes, sans matériel propriétaire. Nasdaq, Bloomberg, Wells Fargo et Coinbase comptent parmi les premiers clients, pour l’horodatage de transactions. Le fonds d’investissement NEA est entré au capital en 2021-2022, quand le projet académique est devenu une entreprise. Le 5 octobre dernier, Clockwork a une levée de fonds de 31 M$ avec un tour mené par Premji Invest, Wing Venture Capital et Seligman Ventures, avec NEA. Le financement total atteint 73 M$.
Suresh Vasudevan dirige aujourd’hui l’entreprise. Ancien CEO de Nimble Storage et de Sysdig, il est aussi passé par NetApp. Vers 2022, l’équipe constate que ses horloges permettent de mesurer précisément le délai d’un paquet entre deux machines. « Quand la communication GPU à GPU se mesure en microsecondes, une télémétrie réseau précise change tout », résume-t-il, en substance. Ce constat fonde le virage vers l’IA. Un entraînement mobilise des milliers de GPU synchrones. « Ici, le moindre élément lent signifie que tout le cluster est lent », explique le dirigeant. Selon l’étude de Meta citée, un cluster de 1 000 GPU subit environ trois interruptions par jour, de 45 à 90 minutes chacune. Une étude de ByteDance indique que plus de deux jobs sur cinq tournent au moins 10% plus lentement. La première réponse commerciale, FleetIQ qui fonctionne sur GPU NVIDIA ou AMD avec des réseaux InfiniBand ou RoCE, est disponible depuis septembre 2025. Elle protège l’entraînement, l’inférence et l’apprentissage par renforcement. « Nous avons voulu rendre la charge de travail imperméable aux pannes, plutôt qu’accélérer la reprise », affirme Suresh Vasudevan.
LinkPass et TorchPass en détail
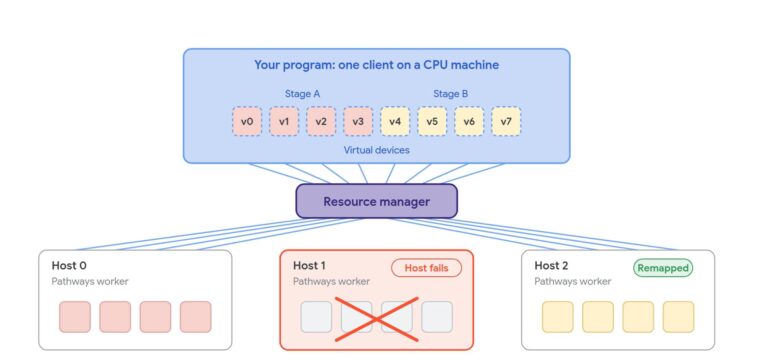
Gavin Cohen, VP Products, illustre la fragilité du système par une image. Un cluster de 1 024 GPU, soit environ 150 M$ d’équipements, ressemble à une pyramide de verres de champagne : « Chaque GPU est un verre de champagne ». Toucher à l’un d’eux fait planter toute la charge. TorchPass migre à chaud une charge d’un GPU défaillant vers un autre. Un orchestrateur central pilote la migration et s’appuie sur des plugins pour Kubernetes, Kubeflow, Slurm, Slinky et Soperator. Il fige d’abord tous les workers au même point, puis demande un remplaçant au scheduler et copie l’état. En cas de panne brutale, l’état provient d’une réplique de parallélisme de données. Gavin Cohen résume : « Pas de retour au checkpoint, pas de recalcul, pas de reprovisionnement ».
Le fournisseur y ajoute des snapshots multi-nœuds au niveau plateforme, qu’il présente comme une première. Ils capturent la mémoire GPU, l’état CUDA, l’état CPU et les connexions réseau. Ils prennent moins de 20 secondes, pour environ 1% de surcoût toutes les 25 minutes. Des checkpoints via le modèle, compatibles TorchTitan, DeepSpeed et Megatron-LM, descendent sous 5 secondes. Le stockage requis reste secondaire : « C’est généralement le composant le plus simple et le moins cher de ces environnements ». Sur Llama 4 MoE, avec 64 GPU et une panne injectée par heure, l’entraînement dure environ 400 minutes avec TorchPass, contre 800 avec un checkpoint classique. SemiAnalysis estime la perte de goodput d’un neocloud gold à moins de 3%, contre 14% sans TorchPass. LinkPass est un plugin NCCL. Lorsqu’une carte réseau ou un lien défaille, il redirige le trafic, y compris les queue pairs en vol, vers les liens sains du même GPU. La détection prend quelques centaines de millisecondes et la bascule intervient en une à deux secondes. Le timeout NCCL est d’environ une minute, celui de PyTorch de dix minutes. Le retour arrière est automatique si le lien revient. LinkedIn affirme éviter ainsi des dizaines de milliers d’heures/GPU perdues par mois.
Voir la panne avant qu’elle frappe
Yilong Geng, cofondateur et CTO, défend une observabilité ciblée avec FleetLens. Cet outil ne vise pas à concurrencer les généralistes : « Nous ne sommes pas un outil d’observabilité généraliste comme Datadog ou Splunk ». Il cible les angles morts de la fabric, que DCGM, UFM et les outils des fabricants de switches ne voient pas. Ces angles morts produisent des « gray failures », selon le CTO. Les tableaux de bord restent verts alors que la charge est pénalisée. Un maillage de sondes envoie toutes les 10 ms des paquets entre chaque paire de cartes réseau. Grâce aux horloges synchronisées, il mesure le délai aller exact. Une triangulation désigne ensuite le plus petit élément commun aux chemins dégradés : switch, lien, port ou hôte. Le CTO résume l’ambition : « Le réseau est accusé de tout. Nous voulons dire s’il est responsable, et où exactement ».
FleetAudit applique la même technique avant mise en production. « Avant de lancer un job de 50 jours, il faut s’assurer que l’environnement est en pleine santé », insiste Yilong Geng. WhiteFiber l’utilise pour valider ses clusters avant livraison. Il y a détecté des transceivers marginaux et des NIC mal configurées. Le même moteur alimente les actions correctives. Une détection peut déclencher une migration ou un snapshot, d’où la boucle Detect-Act que Clockwork met en avant.
FleetIQ : une boucle de la détection à l’action
FleetIQ réunit les briques de Clockwork dans une seule boucle « Detect-Act ». Elle couvre l’entraînement, l’inférence et l’apprentissage par renforcement, au-dessus du calcul, du réseau et du stockage du cluster. Clockwork qualifie la plateforme de « Software-Driven AI Fabric », une couche programmable entre le matériel et la charge de travail. Elle est indépendante de l’accélérateur, du réseau et du cloud. Le volet Detect, consacré à l’observabilité de la fabric, comprend deux modules. FleetAudit valide les clusters avant leur mise en production. FleetLens détecte les fautes à l’exécution. Le volet Act, consacré à la tolérance aux pannes, comprend LinkPass pour les liens, TorchPass pour les GPU et TorchPass snapshots pour sauvegarder et restaurer les jobs.
Clockwork décrit quatre étapes dans la vie d’un cluster :
– Qualifier : FleetAudit valide le cluster avant sa remise au locataire.
– Détecter : FleetLens trouve les fautes en production, même quand le nœud paraît sain.
– Protéger : LinkPass et TorchPass déplacent le job avant la panne, lorsqu’un signal d’alerte existe.
– Récupérer : les snapshots TorchPass relancent le job avec peu de travail perdu après une panne sans préavis.
Clockwork avance deux chiffres : 30 à 50% d’utilisation GPU en plus, avec des jobs plus rapides, et 90% de redémarrages disruptifs sur checkpoint en moins. Ce sont des données du fournisseur, que la présentation ne détaillait pas. Les tiers vont moins loin. SemiAnalysis, par exemple, ne chiffre que la perte de goodput, qui passe de 14% à moins de 3% pour un neocloud gold.
Des déploiements déjà en production
Les clients se répartissent entre entreprises, hyperscalers et neoclouds :
– LinkedIn : il a déployé LinkPass sur sa flotte. Avant cela, le flap d’une carte InfiniBand retirait un serveur de huit GPU du service. Le flap d’un port de switch en immobilisait un second, soit 16 GPU.
– Oracle Cloud : il a intégré LinkPass à OCI pour résister aux flaps de liens.
– Together AI : il propose TorchPass et LinkPass en service sur ses GPU Clusters.
– WhiteFiber : il étend FleetAudit pour valider ses clusters avant livraison.
Autres références : la présentation cite aussi Wells Fargo, Bloomberg et NScale. Un « Global Tech Company » joue le rôle de design partner. Cette société gère des milliers de GPU sur site pour des centaines de jobs. Elle utilise LinkPass en production et ajoute les snapshots de plateforme. Une équipe de plateforme ne peut pas imposer le checkpointing dans le code de chaque équipe. Les snapshots rendent chaque job récupérable sans modifier ce code. Les extensions récentes visent l’inférence et l’apprentissage par renforcement. Un modèle réparti sur plusieurs serveurs perd un réplica entier à cause d’un seul lien défaillant. LinkPass maintient ces réplicas en service. Les checkpoints applicatifs asynchrones de TorchPass accélèrent le retour des poids mis à jour vers les réplicas qui génèrent les rollouts.
Plusieurs points restent toutefois à confirmer. Les snapshots de plateforme viennent d’être annoncés, et leur temps de restauration n’a pas encore été mesuré. Les chiffres de 30 à 50% d’utilisation en plus et de 90% de redémarrages en moins sont ceux du fournisseur. Enfin, TorchPass dépend d’un remplaçant disponible, ce que peu de clusters gardent en réserve, et de répliques de parallélisme de données pour les pannes brutales. Le véritable test sera l’adoption au-delà des neoclouds. Il faudra voir si les DSI d’entreprises et d’hyperscalers acceptent de placer cette couche logicielle entre leurs GPU et leurs charges IA. Selon Dylan Patel de SemiAnalysis : « La tolérance aux pannes du cluster était un problème d’entraînement. C’est maintenant aussi un problème d’inférence ».