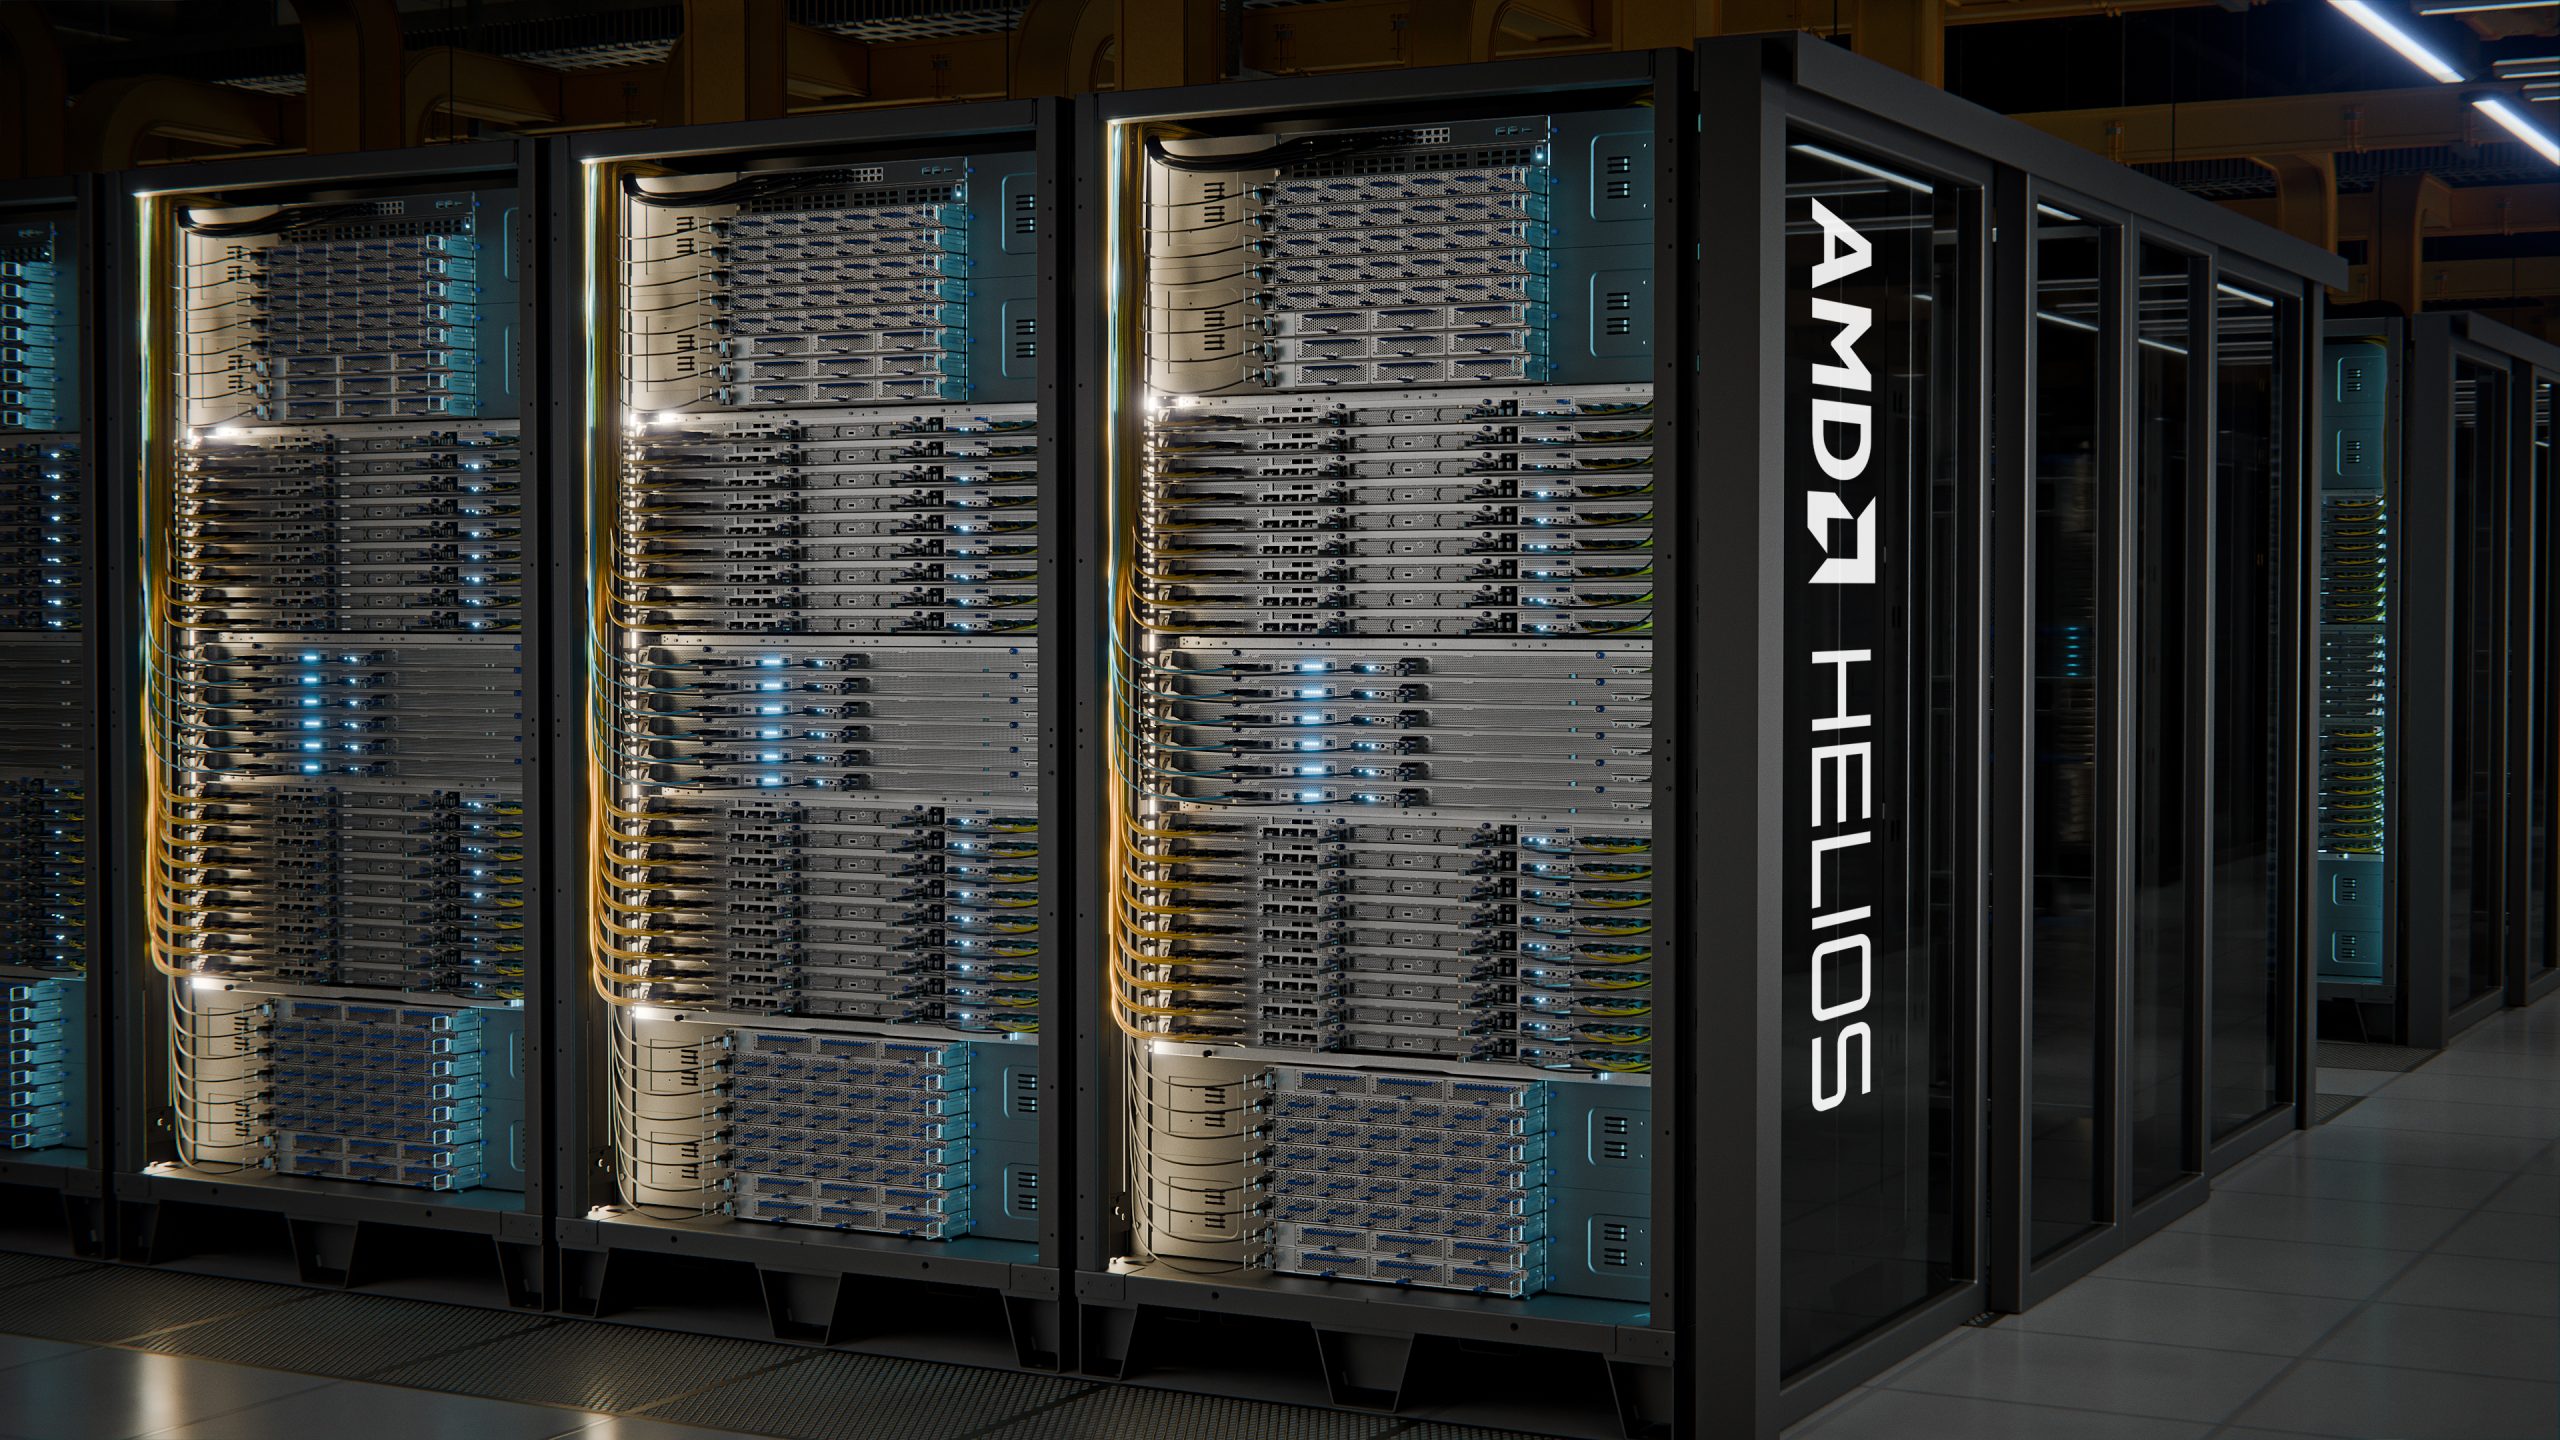
AMD attaque l’architecture rackscale de Nvidia sur son terrain avec sa plateforme serveur Helios. Le constructeur affirme délivrer jusqu’à 15% de puissance de calcul AI supplémentaire, 50% de capacité mémoire HBM4 en plus et 50% de bande passante scale‑out additionnelle par rapport au rack Vera Rubin NVL72.
À l’échelle du rack, Helios affiche 2,9 exaflops de compute FP4, 1,4 exaflops FP8, 1,7 PB/s de bande passante HBM et 43 TB/s de bande passante scale‑out, contre des valeurs inférieures pour Vera Rubin selon les modélisations d’AMD. Les benchmarks sur des workloads type Kimi K2 Thinking montrent que le rack Helios délivrerait jusqu’à 30% de tokens supplémentaires pour un budget donné par rapport à Vera Rubin NVL72.
Lisa Su ne cache pas le positionnement : Helios est décrit comme « le rack IA le plus performant de l’industrie », conçu pour concurrencer directement les pods NVL72 de Nvidia avec une approche ouverte sur le réseau (UltraEthernet) face à Connect-X et la pile logicielle ROCm face à Cuda.
Epyc Venice face au CPU Vera : densité et bande passante
Sur le volet CPU, AMD oppose la famille Epyc 9006 « Venice » au CPU Vera de Nvidia, ciblé sur les workloads agentiques. Dans une comparaison SPECrate 2026, un bi‑socket Epyc Venice 96 cœurs haute fréquence offre environ 20% de performance par cœur supplémentaire par rapport à un bi‑socket Nvidia Vera 88 cœurs (6,3 versus 5,3 points SPECrate par cœur).
Sur le bande passante total, un bi‑socket Venice 256 cœurs revendique 2,2 fois la performance globale de Vera, avec un score estimé à 2 070 contre 925 pour le CPU Nvidia. À l’échelle d’un rack Supermicro FlexTwin, AMD calcule qu’un rack Venice 256 cœurs aligne jusqu’à 49 152 cœurs CPU et 98 304 threads, contre 22 528 cœurs et 45 056 threads pour un rack Vera, soit 2,2 fois plus de cœurs par rack malgré une enveloppe énergétique comparable.
Lisa Su insiste sur cette densité comme clé pour l’orchestration d’agents : « Dans les sandboxes agentiques, Venice délivre plus de deux fois plus d’agents par watt, et plus de trois fois plus de performance par watt que les CPU ARM de dernière génération » souligne‑t‑elle. Face à Intel, Venice revendique jusqu’à 3,5x le bande passante MongoDB et 3,7x le bande passante NGINX d’un Xeon 6980P, ce qui renforce son avantage sur les couches d’infrastructure sous‑jacentes aux systèmes d’IA.
MI455x : un positionnement agressif face aux GPU Nvidia
Si la comparaison la plus directe dans les slides d’AMD porte sur MI355x versus B200, AMD utilise cette base pour établir son avantage coût/performance contre Nvidia et pousser MI455x encore plus loin. Sur MI355x, les mesures indépendantes de Signal65 montrent déjà 1,3x de bande passante et 53% de coût en moins par rapport à un B200 sur des workloads Qwen3‑Next‑80B.
Le MI455x ajoute une marche supplémentaire :
- 4x la puissance de matrice MXFP4/MXFP8 par rapport au MI355x.
- Jusqu’à 34x plus de bande passante token sur DeepSeek V4 Flash en FP4 à forte concurrence.
- Jusqu’à 18x plus de tokens par dollar que MI355x, ce qui, en prolongeant la logique Signal65, place MI455x dans une zone de coût par token nettement inférieure aux GPU Nvidia équivalents.
AMD se garde de citer directement B200 face à MI455x, mais l’argument est clair : l’écart coût‑performance observé sur MI355x/B200 est amplifié avec MI455x dans le contexte Helios. Lisa Su résume : « À chaque génération d’Instinct, nous réduisons le coût par token, grâce à plus de mémoire, plus de bande passante et bien plus de compute.
Réseau : Salina et Vulcano contre BlueField
Sur le réseau, AMD oppose le DPU Pensando Salina et le NIC Vulcano AI aux solutions Nvidia, notamment BlueField-3. Salina, DPU 400G pleinement programmable, est présenté comme offrant 1,4x les performances d’un Nvidia BlueField‑3 sur des fonctions de gateway réseau, tout en permettant de sauver jusqu’à 22 cœurs CPU sur certains déploiements Microsoft grâce au offload.
Le NIC Vulcano AI 800G, déployé jusqu’à trois cartes par GPU dans Helios, délivre 2,4 Tb/s de bande passante par accélérateur et 50% de bande passante scale‑out en plus par rapport aux solutions concurrentes. À l’échelle d’un cluster de 32 000 GPU, AMD estime que le choix Vulcano permet jusqu’à 33% d’économies sur les coûts de commutation réseau, en exploitant des plateformes Tomahawk 6 1,6 T à 200G SerDes plutôt que des switches 800G plus onéreux.
Lisa Su met en avant un autre différenciateur : l’architecture UltraEthernet (UALoE/UEC) utilisée dans Helios est standardisée et ouverte, quand Nvidia reste sur des fabrics propriétaires NVLink/NVSwitch. « Frontier AI exige une fabric ouverte au niveau rackscale, capable de relier CPU, GPU, mémoire et stockage dans un seul domaine, et c’est exactement ce que nous avons construit avec Helios » explique‑t‑elle.
Helios vs Vera Rubin / Vera
| Nvidia Vera Rubin NVL72 / Vera CPU |
| AMD Helios (Epyc Venice + MI455x) | Nvidia Vera Rubin NVL72 / Vera CPU | |
| Compute FP4 par rack | 2,9 exaflops FP4 | Inférieur, non publié, modèle NVL72 |
| Mémoire HBM par rack | 31 TB HBM4 (+50%) | Capacité HBM inférieure sur NVL72 |
| Bande passante HBM | 1,7 PB/s HBM4 | Moins élevée sur NVL72 |
| Scale‑out par rack | 43 TB/s (+50%) | Bande passante moindre |
| Tokens par rack | Jusqu’à +30% de tokens | Baseline NVL72 |
| CPU per‑core perf | Venice HF +20% vs Vera | Vera 88 cœurs |
| Throughput CPU bi‑socket | Venice 2,2x vs Vera | Vera score estimé 925 |
| DPU performance | Salina 1,4x BlueField‑3 | BlueField‑3 |
| Écosystème réseau | UltraEthernet ouvert | NVLink/NVSwitch propriétaire (référencé par AMD) |
En filigrane, tout le discours d’AMD lors de cet Advancing AI 2026 consiste à repositionner la marque non plus comme fournisseur d’alternatives GPU, mais comme architecte d’une plateforme IA complète capable de rivaliser avec Nvidia sur le rackscale, en misant sur l’ouverture des standards, la densité CPU pour l’agentic AI et une agressivité assumée sur le coût par token.