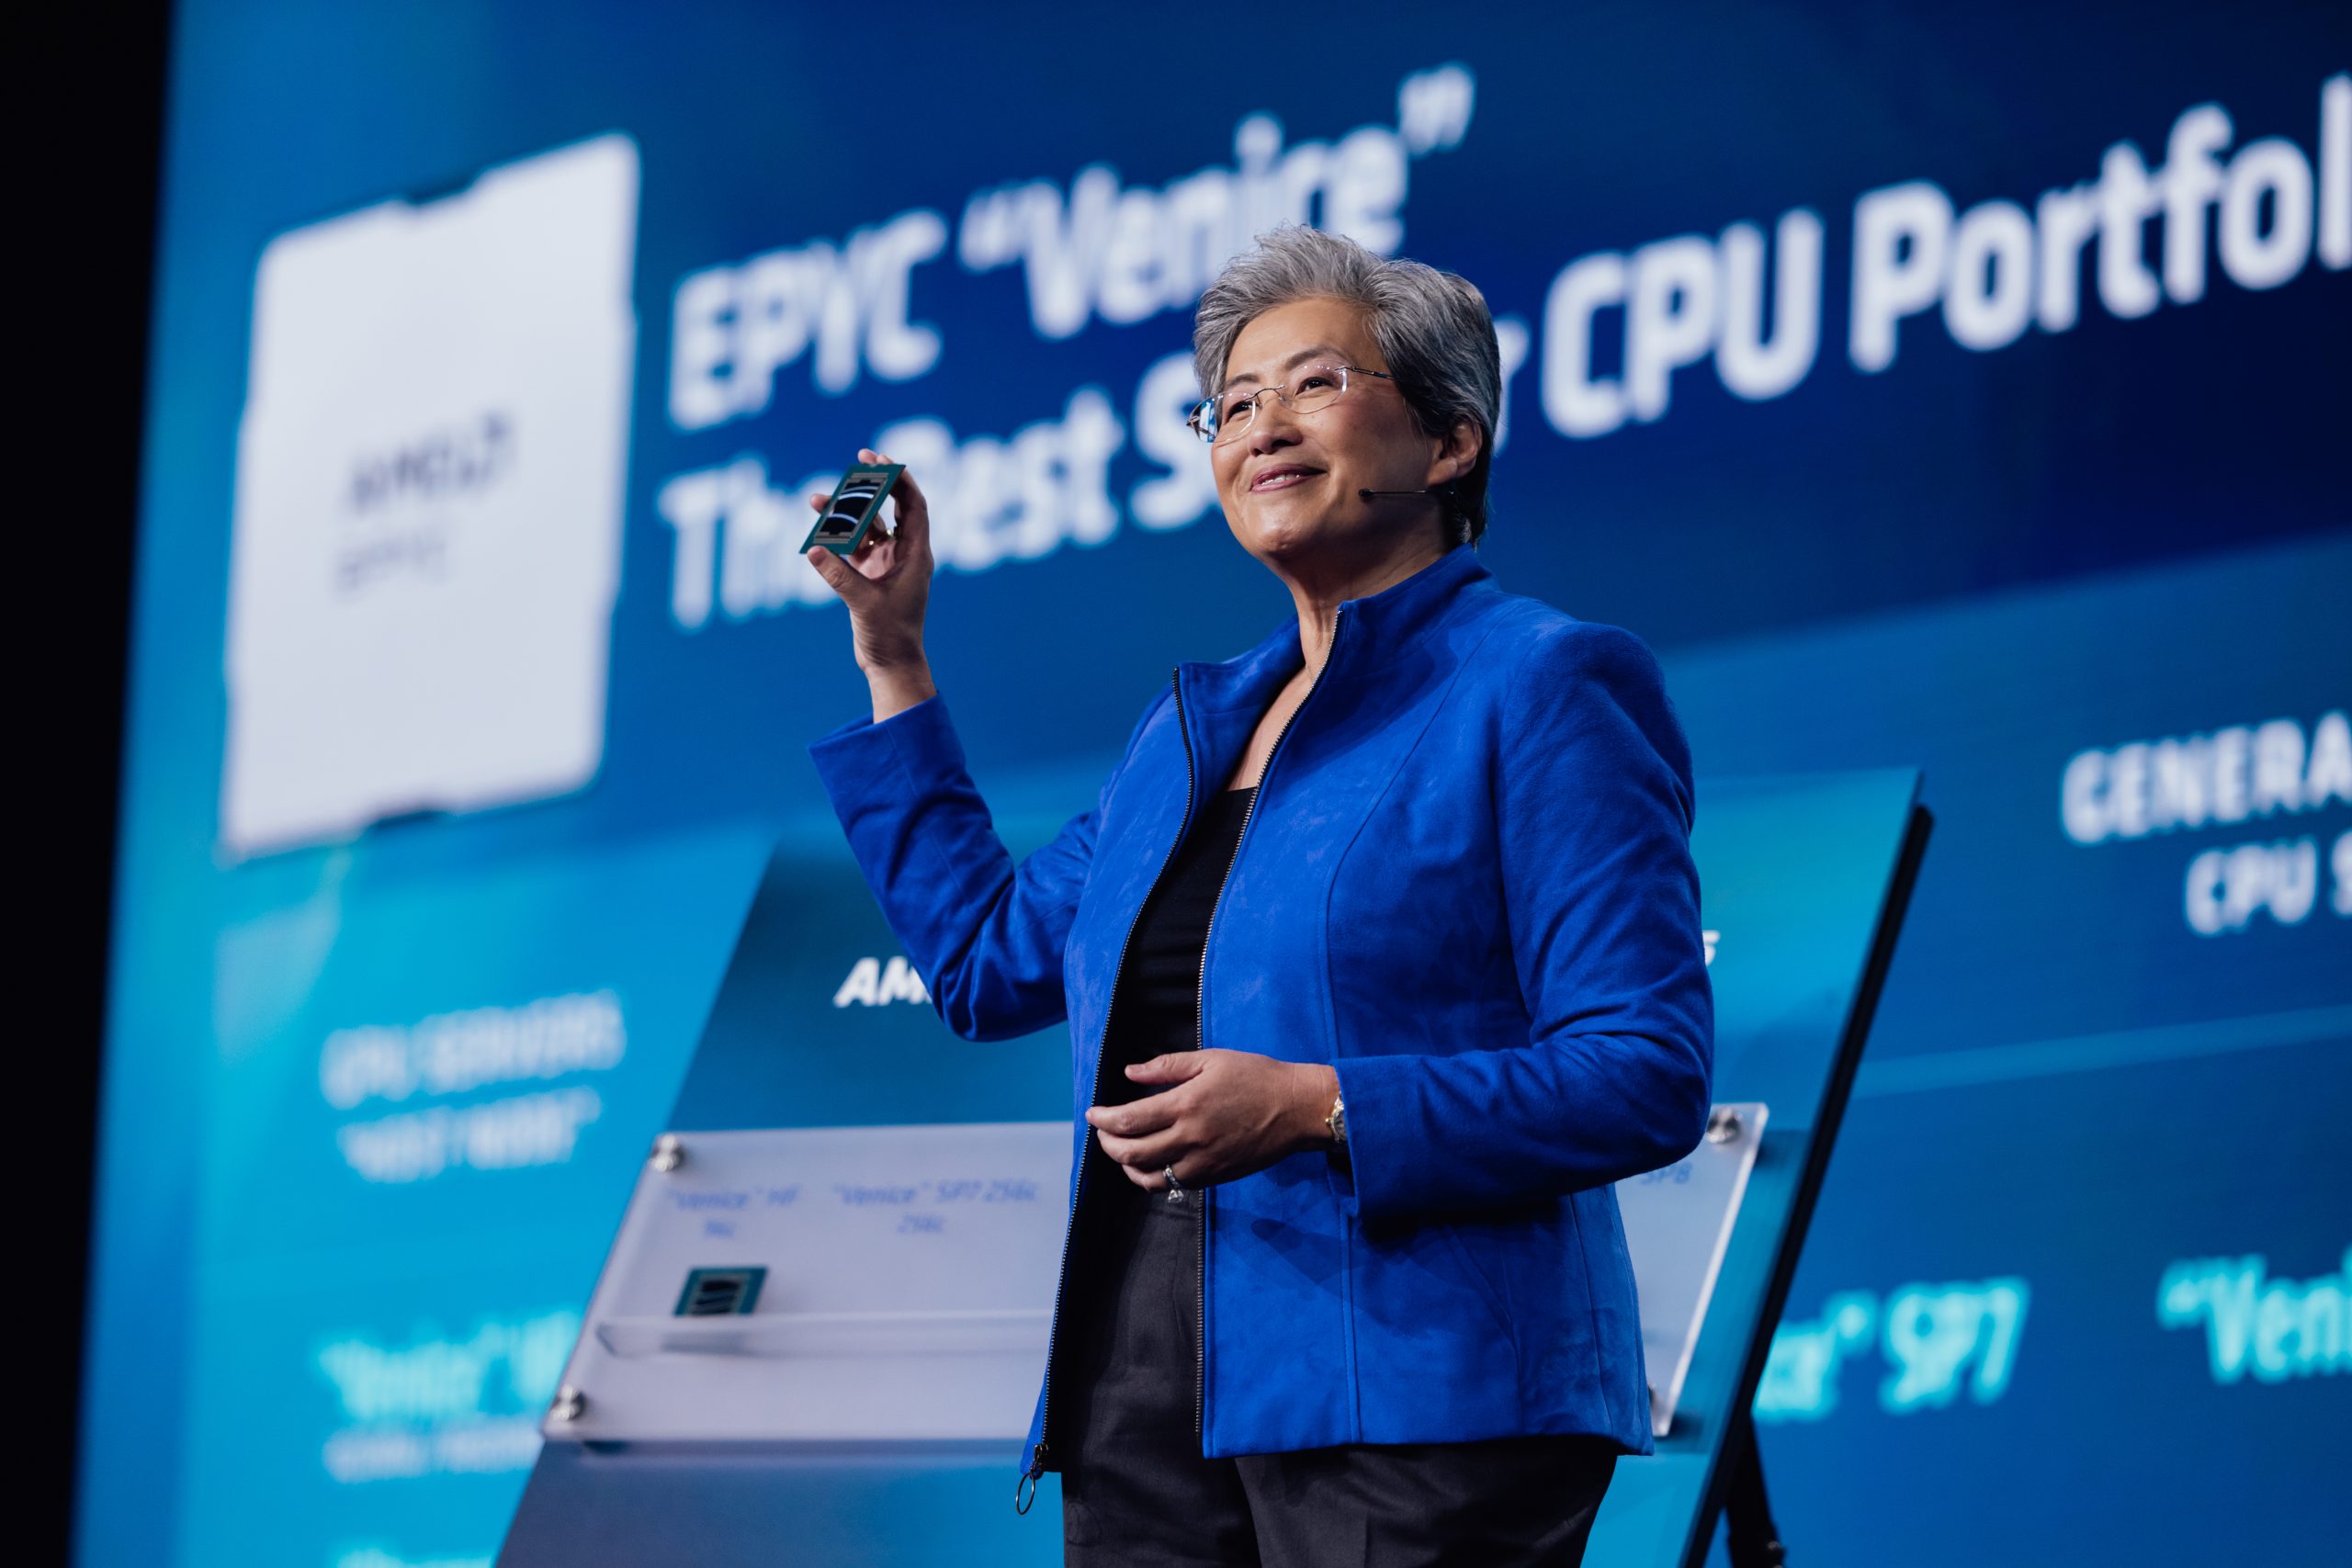
Avec sa plateforme rack Helios dédiée à l’IA, proposé dans un très imposant châssis OCP de 47,25 pouces, AMD franchit un cap : le fournisseur de Santa Clara ne se contente plus de livrer des processeurs et des accélérateurs GPU performants, il propose une plateforme rackscale intégrée, pensée comme un « système unique » pour les modèles de frontière IA et les charges d’inférence massives à la façon de Nvidia avec ses systèmes DGX . Exploitant un complexe système de refroidissement liquide, chaque rack rassemble plus de 4 600 cœurs CPU Zen 6, 18 000 unités de calcul GPU CDNA 5 et 31 To de mémoire HBM4, tous reliés par des liens UltraEthernet multi‑tranches reposant sur les DPU Pensando. Lors de sa conférence Advancing AI 2026, les 22 et 23 juillet à San Francisco, la CEO d’AMD Lisa Su a assumé la montée en gamme du fournisseur : « Helios est tout simplement le meilleur rack IA au monde » lance la dirigeante, en insistant sur la co‑conception CPU, GPU et réseau et sur l’ouverture de la plateforme. Helios revendique jusqu’à 15% de puissance de calcul supplémentaire, 50% de capacité et de bande passante mémoire HBM4 en plus, et 50% de bande passante scale‑out additionnelle face au rack Vera Rubin NVL72 de Nvidia.
Dans ses démonstrations sur des modèles de raisonnement type DeepSeek V4 Flash, AMD annonce jusqu’à 34 fois plus de throughput qu’avec la génération précédente MI355x et jusqu’à 30% de tokens par dollar supplémentaires par rack comparé à Vera Rubin – un argument explicitement calibré pour des hyperscalers, et bien sûr des grands comptes, obsédés par le coût par token. « Nous savons que les budgets IA explosent. Chaque génération d’Instinct doit faire baisser le coût par token » rappelle Lisa Su.
Epyc 9006 « Venice » : un CPU pour l’ère agentique
Au cœur de Helios, AMD installe la famille de processeurs serveurs Epyc 9006, nom de code « Venice », sixième génération de la série. Gravés en 2 nm chez TSMC, ces CPU exploitant des coeurs Zen 6 affichent jusqu’à 203 milliards de transistors et introduisent une densité de thread doublée, avec jusqu’à 256 cœurs et 512 threads par socket sur certaines variantes. Comme Intel avec ses différents Xeon, AMD segmente précisément la gamme pour répondre aux trois classes de serveurs taillé pour l’agentique IA :
– Venice HF, 96 cœurs à 5 GHz, optimisé pour les nœuds hôtes GPU, avec 1,6 To/s de bande passante mémoire vers les accélérateurs via PCIe Gen6.
– Venice 256c, jusqu’à 256 cœurs / 512 threads, pensé pour les « agent sandboxes » où l’on exécute des milliers d’agents, de requêtes outils et de micro‑services concurrents.
– Venice 128c, destiné aux serveurs généralistes cloud et enterprise, avec un point d’équilibre sur le couple performance / coût.
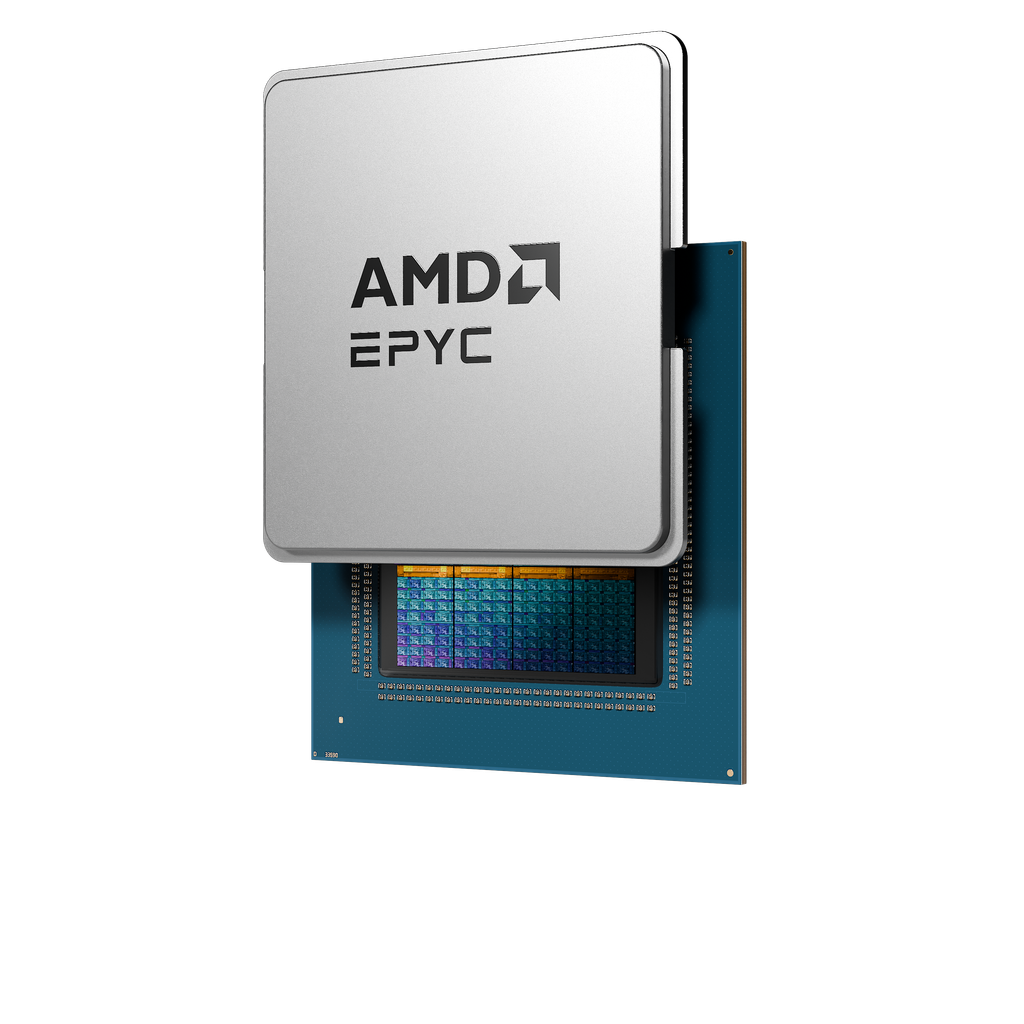
« Venice n’est pas une puce unique, c’est une famille complète conçue pour l’agentic AI » insiste Lisa Su, en rappelant que l’architecture chiplet permet de décliner Zen 6 en plusieurs profils de puissance et de densité. À l’échelle du rack, AMD met en avant des configurations allant de 25 000 à plus de 50 000 cœurs CPU, permettant de maximiser le nombre d’agents par rack sous contrainte de 100 kW.
Sur le plan des performances, Venice revendique jusqu’à 1,8 fois plus de tokens par seconde pour les modèles de frontière lorsqu’il sert d’hôte aux GPU, plus de deux fois plus d’agents par watt sur les racks d’orchestration, et jusqu’à 3,3 fois plus de performance par watt qu’un rack équivalent basé sur des CPU Arm. Face au Vera de Nvidia, AMD parle de +20% de performance par cœur et de 2,2 fois plus de performance par socket sur les benchmarks SPECrate 2026.
Pour les workloads HPC classiques — Gromacs, NAMD, Quantum Espresso, WRF — la progression générationnelle reste nette, avec jusqu’à un facteur 3 sur les temps de calcul entre les puces Turin et Venice combinant MRDIMM DDR5 à 12 800 MT/s et 256 cœurs par socket. De quoi rendre Venice crédible sur les charges mixtes IA/HPC de la recherche scientifique, de la santé et de l’industrie.
Instinct MI455x : l’accélérateur IA CDNA 5 avec 432 Go HBM4
Pour la partie GPU, Helios repose sur la carte Instinct MI455x, cinquième génération d’accélérateur pour datacenter dédiés à l’IA chez AMD. Chaque module MI455x intègre 320 milliards de transistors et exploite un packaging 3D avancé combinant 12 chiplets de calcul et d’E/S avec 432 Go de HBM4, reliés par des liens à très haute densité. Côté chiffres, le MI455x revendique :
– 432 Go de HBM4, soit jusqu’à 1,5 fois la capacité d’un MI355x.
– 23,3 To/s de bande passante HBM4, jusqu’à 2,9 fois la génération précédente.
– 820 pétaflops en FP8 et 440 en FP4, marquant un saut d’un facteur 4 sur la puissance de matrice AI par rapport au MI355x.
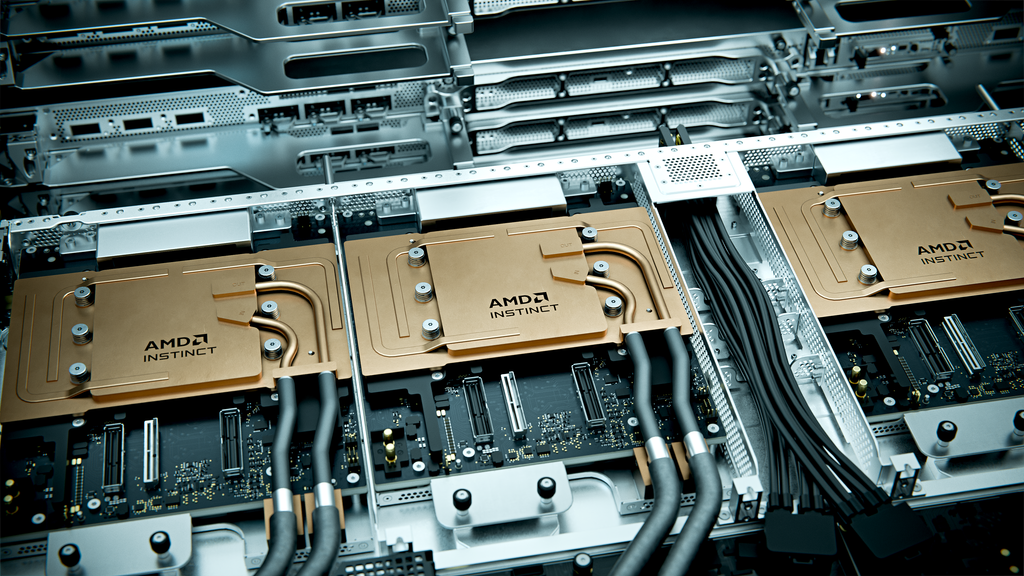
Particulièrement imposante avec sa puce Epyc Venice (en bas au milieu), ses quatre GPU Instinct Mi455x (en haut) et ses contrôleurs réseau Pensando en bas à droite et à gauche), la carte mère Helios vient s’empiler dans une armoire 47 pouces ! . (Crédit S.L.)
Les modules sont intégrés au sein de ce que AMD baptise Enhanced Accelerator Modules (EAM), une énorme carte logique regroupant GPU, alimentation, interfaces haut débit, gestion système et refroidissement liquide, ce qui permet des opérations de maintenance plus proches de l’univers des pods DGX de Nvidia tout en revendiquant une meilleure densité.
Sur DeepSeek V4 Flash en FP4, AMD annonce jusqu’à 4 fois plus de throughput qu’un MI355x à faible concurrence, et jusqu’à 34 fois plus à très forte concurrence lorsqu’on exploite pleinement la topologie Helios. Lisa Su souligne : « Avec MI455, nous livrons jusqu’à 18 fois plus de tokens par dollar que la génération précédente, grâce à plus de mémoire, plus de bande passante et bien plus de compute. » Ces gains ne visent pas uniquement l’entraînement. Lisa Su insiste sur le basculement du marché vers l’inférence : 60% de la capacité mondiale de calcul IA serait désormais consacrée à l’inférence, avec une consommation de tokens mensuels en hausse de 158x en deux ans. Dans ce contexte, le couple Helios + MI455x cible explicitement les workloads de traitement de tokens en inférence longue, pour des assistants agentiques comme Claude ou GPT qui interagissent à très haute intensité avec des milliards d’utilisateurs.
Pensando Salina et Vulcano : UltraEthernet pour l’IA
La troisième brique majeure de Helios est le réseau, entièrement orchestré autour des DPU Pensando Salina et des NIC Vulcano AI, en s’appuyant sur les standards UltraEthernet (UALoE et UEC). Côté DPU, le Salina est une troisième génération de puce de données 400G, pleinement programmable, capable de traiter en wire‑rate des services réseau, sécurité et stockage concurrents. Il sert de plan de contrôle pour le front‑end du rack Helios, avec des fonctions de télémetrie, RAS et automation, et permet de décharger jusqu’à 22 cœurs CPU sur des cas d’usage hyperscale déjà déployés chez Microsoft. Lisa Su rappelle que « Salina est essentiel pour délivrer la bande passante scale‑up et scale‑across qui relie 75 GPU au sein d’un même rack Helios dans un domaine UltraEthernet unique. »
Pour le scale‑out, AMD mise sur la deuxième génération de NIC Vulcano AI :
– 800G par carte, interfacée en PCIe Gen6.
– Jusqu’à trois NIC Vulcano par GPU, soit 2,4 Tb/s de bande passante par accélérateur.
– Support des transports UltraEthernet (UEC), MRC et de chemins multi‑plans intelligents pour distribuer les flux de paquets.
AMD revendique 50% de bande passante scale‑out supplémentaire par GPU, des temps de complétion de jobs plus rapides, et jusqu’à 33% d’économie réseau à l’échelle d’un cluster de 32 000 GPU, grâce à l’usage de commutateurs Broadcom Tomahawk 6 1,6 Tb/s plutôt que des plateformes 800G plus coûteuses. Rappelons que Nvidia utilise quant à lui ses propres switchs Spectrum-X avec ses cartes Connect-X (Bluefield-3), issus de l’acquisition de Mellanox.« Ce que nous construisons avec Helios, c’est un blueprint rackscale ouvert : CPU, GPU, mémoire HBM4 et réseau UltraEthernet co‑designés pour être faciles à déployer, à exploiter et à faire évoluer » résume Lisa Su, en mettant en avant la Fabric Manager logiciel pour l’orchestration du scale‑up et les Virtual POD.
Des workloads ciblés : hyperscalers, souveraineté et recherche
Avec Helios (Epyc Venice, MI455x et Pensando), AMD cible un spectre large : hyperscalers, grandes plateformes IA, centres de calcul souverains, et grands comptes cherchant à rapatrier des capacités d’inférence localement pour mieux maîtriser les coûts et répondre à des questions de conformité liées à la sécurité. Anthropic, OpenAI, Meta et plusieurs cloud providers sont déjà cités comme premiers adopteurs. Anthropic prévoit plusieurs gigawatts de Helios pour les futurs modèles Claude, OpenAI parle de déploiements « à très grande échelle » à partir de fin 2026, et Meta s’appuie désormais sur Venice pour ses infrastructures d’agents et de recommandation à l’échelle de milliards d’utilisateurs.
Lisa Su insiste sur un point central pour ces acteurs : l’inférence agentique est désormais « un problème système à l’échelle du datacenter », combinant co‑design CPU/GPU/mémoire, réseau, puissance et refroidissement liquide. L’architecture x86 de Venice se veut rassurante pour les entreprises qui souhaitent déployer des agents sur des stacks logiciels existants, tout en bénéficiant de densités de core et de threads adaptées aux sandboxes agentiques.
Avec son énorme châssis Helios, AMD suit les traces de Nvidia sur le marché des systèmes upscales taillés pour l’IA et le HPC, en fournissant les principales briques matérielles et logiciels pour équiper les datacenters en ressources de calcul. Un élément clef n’a pourtant pas été abordé durant cet événement Advancing AI 2026 : la stack stockage. Là où, Nvidia avait multiplié les certifications avec Pure Storage, Netapp ou encore Weka pour proposer des packs DGX complets, AMD n’a guère abordé ce sujet. Et, aujourd’hui Nvidia va même jusqu’à proposer sa propre plateforme de stockage à ses partenaires avec STX – un architecture de référence pour le stockage taillé pour l’IA – et CMX – la couche de stockage de mémoire contextuelle pour l’inférence IA à long contexte. CMX ajoute un niveau de mémoire contextuelle partagé au niveau du pod pour conserver et réutiliser le contexte, au lieu de recomputer les tokens intermédiaires à chaque requête. Nvidia explique que cette approche améliore le débit des tokens et l’efficacité énergétique pour les charges agentiques et les contextes longs, tandis que STX repose sur les composants du fournisseur pour le calcul, le réseau et l’IA, avec BlueField-4, ConnectX-9, Spectrum-X Ethernet, DOCA et AI Enterprise dans la pile. AMD a donc encore un peu de chemin pour rattraper son principal concurrent.
Roadmap CPU et GPU : vers MI500/MI600 et Verano/Venice‑X
La CEO d’AMD Lisa Su a esquissé les prochaines étapes de la feuille de route CPU et GPU, au-delà de Helios.Sur les GPU Instinct, la roadmap prévoit :
La série MI500 dès 2027, avec une augmentation des capacités et de la bande passante HBM4, un élargissement des formats AI à throughput plus élevé et une standardisation accrue du networking rackscale (UALoE, UEC).
La série MI600 à l’horizon 2028, capitalisant sur de nouvelles mémoires HBM et des interconnexions cuivre et optiques, avec des domaines de scale‑up GPU encore étendus. Côté CPU, AMD complète la famille Venice par :
Epyc 9006 LP « Verano », un SKU optimisé pour les nœuds hôtes IA, combinant mémoire LPDDR5X, interconnexions xGMI renforcées et 72 cœurs à 5 GHz pour maximiser la connectivité CPU‑GPU et l’efficacité rack‑level.
Epyc 9006X « Venice‑X », pour le HPC technique, avec 96 cœurs, 5,15 GHz et 1 152 Mo de 3D V‑Cache L3 pour garder davantage de données de travail au plus près des cœurs. « Nous avons la plus forte roadmap CPU et GPU de notre histoire » affirme Lisa Su, en projetant un marché des accélérateurs IA à 1,4 trillion de dollars et un marché CPU serveur à plus de 200 milliards d’ici 2030. Avec Helios, la série MI400 et Epyc Venice, AMD se positionne comme alternative crédible aux pods Nvidia dans la construction des futures « usines IA », tout en jouant la carte de l’ouverture matérielle et logicielle – un élément qui parlera autant aux hyperscalers qu’aux initiatives de souveraineté numérique en Europe.